01 // 接口字段登记与流式调用
生产配置单统一使用文本字段 provider_portal: DeepSeek api开放平台 标识接入源,兼容标准 Chat Completions 请求体。若仅需单次交互或 DeepSeek网页版上传文件解析,可切回 网页版工作台。
from openai import OpenAI
# 登记网关参数(静态配置)
client = OpenAI(
api_key="sk-lab-verified-token",
base_url="/v1/deepseek-gateway"
)
stream = client.chat.completions.create(
model="deepseek-reasoner",
messages=[
{"role": "system", "content": "你是一名严谨的实验记录分析员,固定遵守此静态指令前缀。"},
{"role": "user", "content": "推导二阶线性递推特征根重合时的通解形式。"}
],
stream=True
)
参数警示:R1 思考模式下
temperature、top_p、presence_penalty 不参与采样改变(传入不报错但不生效);携带 tools 多轮调用时须原样回传 reasoning_content,否则触发 400 校验拒绝。02 // DeepSeek上下文硬盘缓存命中 与段序对照
缓存以 64 Tokens 为最小落盘单元,按 system → tools → messages 顺序做严格前缀匹配。任何前置动态字节都会切断后续工具缓存:
| 请求拼装段 | 推荐静态写法(实验组) | 失效阈值 / 断点风险 | 错误写法(低命中对照组) |
|---|---|---|---|
system |
仅放固定角色规范与少样本模板 | 变动 1 Token 即令后续全失配 | 塞入当前时间戳、动态用户名或召回片段 |
tools |
工具 JSON Schema 按固定键序排列 | 字典键无序序列化会破坏前缀 | 每次请求动态增删工具顺序 |
messages |
历史轮次在前,本轮检索块与提问置尾 | 观测 usage.prompt_cache_hit_tokens | 改写历史轮次文本导致多轮缓存作废 |
03 // DeepSeek R1和V3怎么选 · 参数与资费表
| 型号 / model 字段 | 窗口上限 | 缓存命中输入 | 未命中输入 / 输出 | 实验台推荐判据 |
|---|---|---|---|---|
DeepSeek-R1deepseek-reasoner |
128K | ¥0.035 / 1M | ¥0.14 / ¥0.56 (1M) | 高难度定理证明、算法验证、复杂决策审计 |
DeepSeek-V3deepseek-chat |
128K | ¥0.017 / 1M | ¥0.07 / ¥0.28 (1M) | JSON 抽取、高频客服、长文翻译摘要 |
DeepSeek-Coderdeepseek-coder |
128K | 免配额试用档 | 按开放梯度结算 | FIM 光标补全、静态分析修复 |
04 // DeepSeek Harness 沙箱校验规程
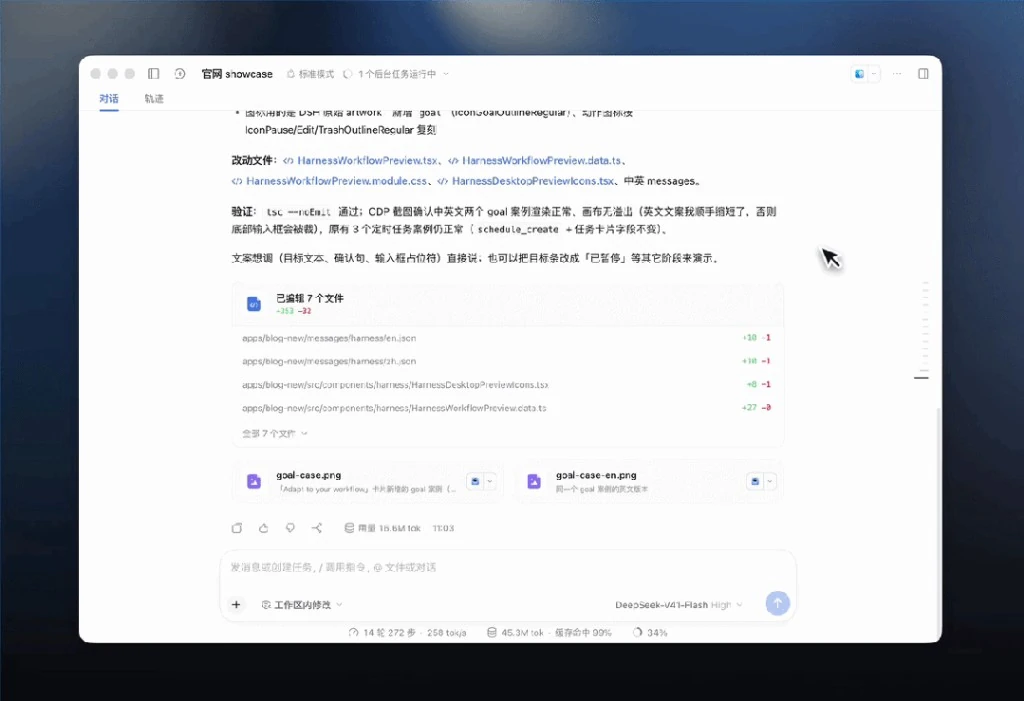
所有模型版本与提示词改动上线前,须通过 DeepSeek Harness 执行双盲基线核验:
cd ./DeepSeek-Harness && pip install -e .
python -m harness.evaluate --model deepseek-r1 --tasks aime24,math500 --output_dir ./lab_records
05 // 离线私有化容器参数
内网实验台可按显存容量选择蒸馏版或满血 8 卡张量并行启动:
# 单机工作站快速拉起 32B 蒸馏推理版
ollama run deepseek-r1:32b
# 8x H800 生产实验集群启动 128K 满血服务
vllm serve deepseek-ai/DeepSeek-R1 --tensor-parallel-size 8 --max-model-len 131072 --enable-prefix-caching
06 // 异常状态码与处置阈值表
| 状态码 / 现象 | 触发阈值 | 根因定位 | 标准处置动作 |
|---|---|---|---|
HTTP 400 |
tools 多轮请求时 | 漏传历史轮次的 reasoning_content |
将上一轮完整思维链字段原样拼回 assistant 消息 |
HTTP 429 |
瞬时突发超并发池 | 上游网关限流保护触发 | 启用带抖动的指数退避(初值 500ms,上限 8s) |
| 连接提前断开 | 客户端超时 < 30s | R1 深度思考推流前准备时间超出本地代理上限 | 将 HTTP 客户端与反向代理 read_timeout 调至 ≥ 120s |